Получение отдельных элементов
В этом уроке показано, как получить один элемент из списка: по его позиции, по условию или случайным образом. Также показано, как проверить, есть ли элемент в списке вообще.
В Python есть None — специальное значение, которое означает «нет значения». Если поиск может закончиться неудачей, функция Python может вернуть элемент или None, а вызывающий код проверяет результат с помощью is not None.
Чтение несуществующей позиции, например words[5] в списке из 5 элементов, останавливает программу с ошибкой IndexError (ошибка во время выполнения). Поэтому мы либо сначала проверяем len(), либо используем вспомогательную функцию, которая делает это за нас.
В других языках для этого есть много готовых функций. В Python обходятся несколькими инструментами: квадратными скобками, встроенной функцией next() со значением по умолчанию и небольшой вспомогательной функцией, которую вы пишете один раз.
Получение по позиции
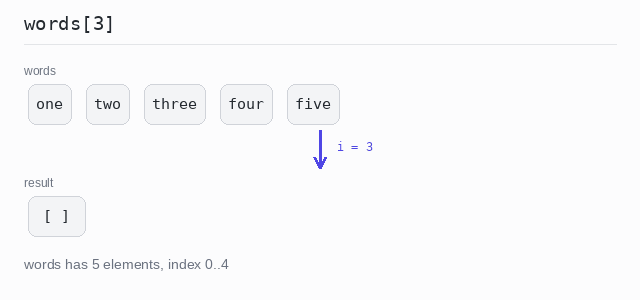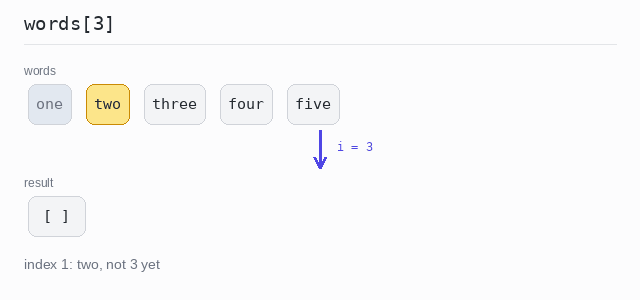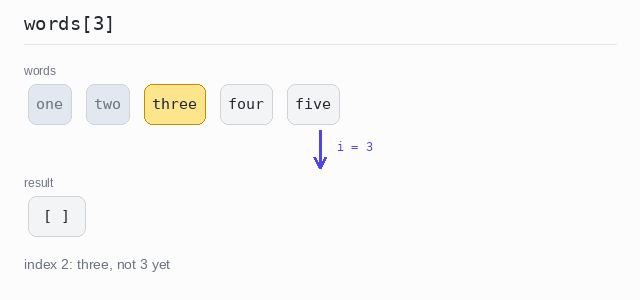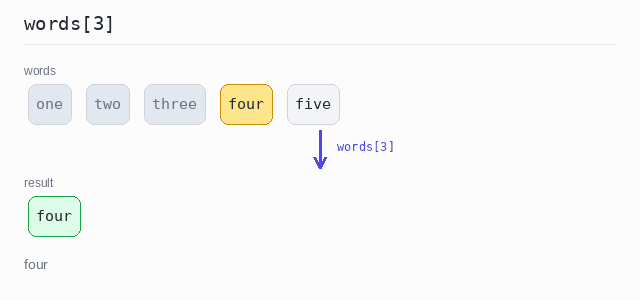
У каждого элемента списка есть позиция, которая называется индексом. Первый индекс равен 0, поэтому последний — len(words)-1.
Чтобы прочитать элемент по позиции, укажите индекс в квадратных скобках: words[3]. Python умеет считать и с конца: отрицательный индекс, например words[-1], читает последний элемент без всяких вычислений с длиной.
В Python нет element_at_or_none() или element_at_or_else(). Небольшая вспомогательная функция сравнивает индекс с len() и возвращает либо элемент, либо None, либо результат резервной функции. Так индекс вне диапазона не может вызвать IndexError.
Элемент на заданной позиции
words[3] читает элемент с индексом 3. Поскольку счёт начинается с 0, это четвёртое слово.
Вывод: полная программа на Python
words = ["one", "two", "three", "four", "five"]

# Позиции начинаются с 0, поэтому индекс 3 — это четвёртый элемент.
print(words[3])
Первый и последний элемент
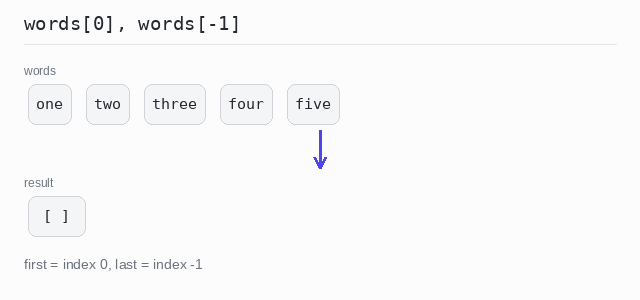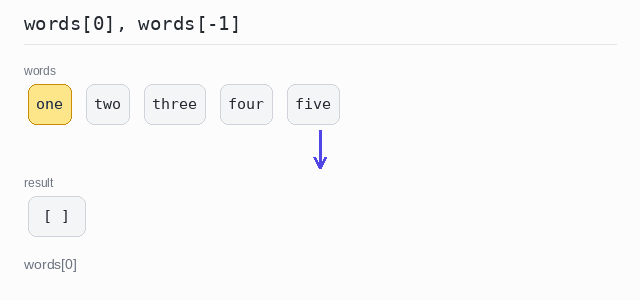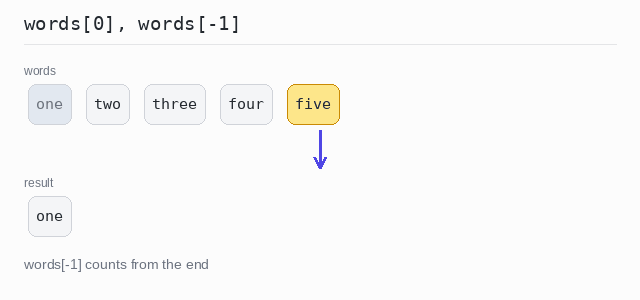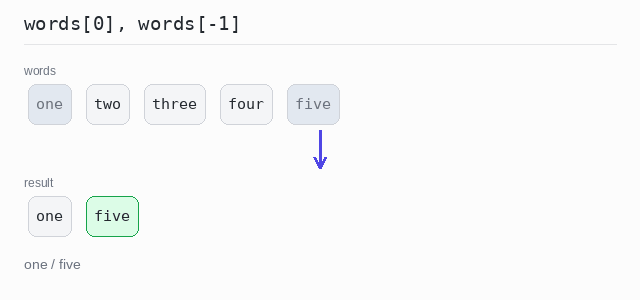
Первый элемент — words[0]. Последний — words[-1]: отрицательный индекс отсчитывается с конца, поэтому -1 — это последний элемент, а -2 — предпоследний.
Вывод: полная программа на Python
words = ["one", "two", "three", "four", "five"]

# Первый элемент имеет индекс 0; отрицательный индекс отсчитывается с конца.
print(words[0])
print(words[-1])
Элемент на позиции или None
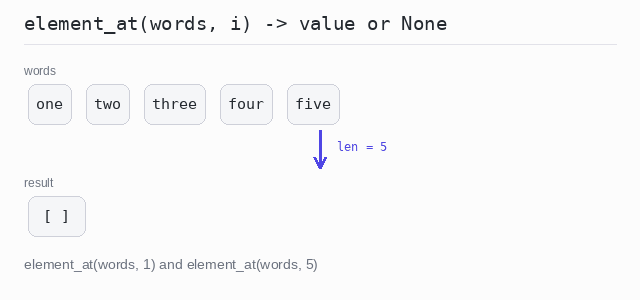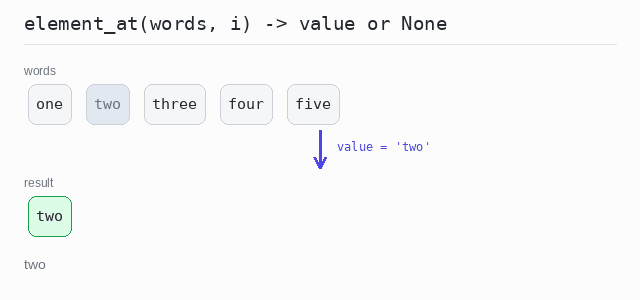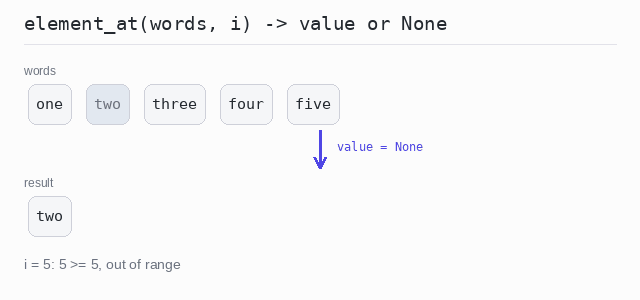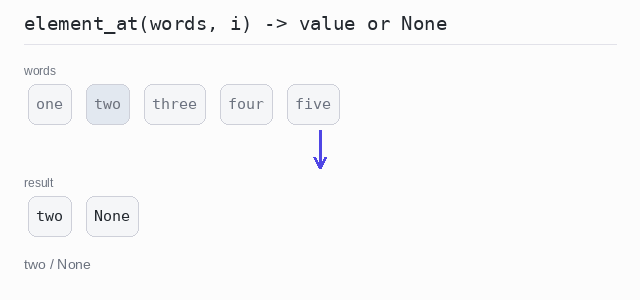
element_at сравнивает индекс с len(). Индекс 1 входит в диапазон, поэтому функция возвращает слово two. Индекс 5 выходит за пределы диапазона, поэтому функция возвращает None вместо того, чтобы вызвать IndexError.
Вывод: полная программа на Python
def element_at(items, i):
  # None вместо IndexError, если индекс вне диапазона.
  if i < 0 or i >= len(items):
    return None
  return items[i]

words = ["one", "two", "three", "four", "five"]

print(element_at(words, 1))

# Индекса 5 нет: никакого IndexError, просто None.
print(element_at(words, 5))
Элемент на позиции или резервное значение
element_at_or_else принимает резервную функцию. Эта функция получает индекс, поэтому может составить сообщение вроде «Значение для индекса 5 не определено».
Вывод: полная программа на Python
def element_at_or_else(items, i, fallback):
  # Индекс вне диапазона: вместо элемента возвращаем результат fallback(i).
  if i < 0 or i >= len(items):
    return fallback(i)
  return items[i]

words = ["one", "two", "three", "four", "five"]

print(element_at_or_else(words, 5,
                         lambda i: f"Значение для индекса {i} не определено"))
Получение по условию
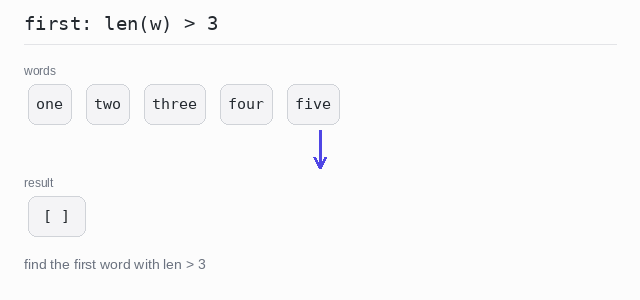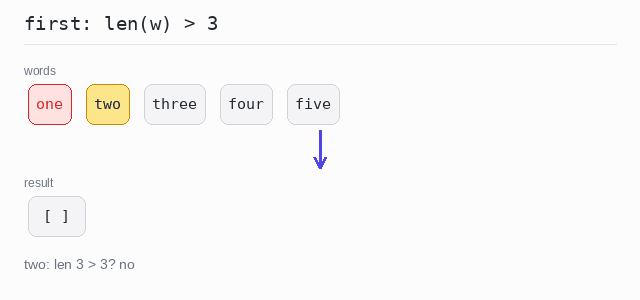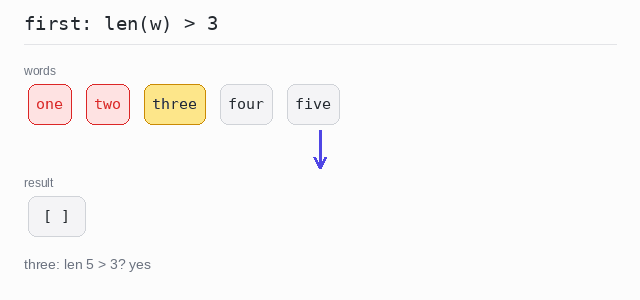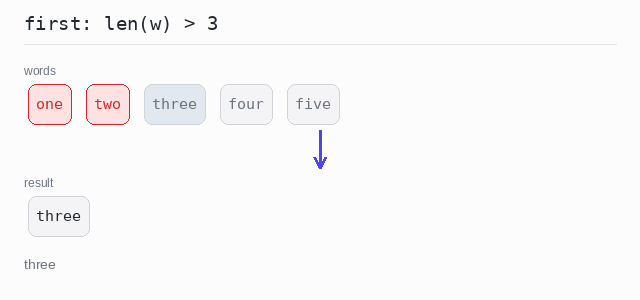
Часто позиция неизвестна. Зато известно условие: первое слово длиннее 3 букв, последнее слово, которое начинается с "f". Условие записывается в генераторном выражении, например w for w in words if len(w) > 3, которое выдаёт только подходящие слова.
Чтобы получить первое совпадение, передайте генератор встроенной функции next(). Она берёт первое значение, которое выдаёт генератор, и на остальные не смотрит. Если ничего не подошло, next() вызывает ошибку StopIteration — если только вы не передали ей второй аргумент, значение по умолчанию, которое тогда и возвращается.
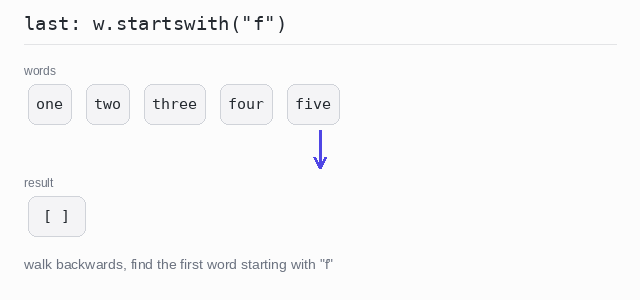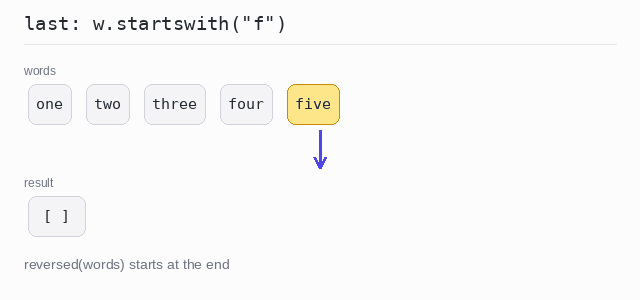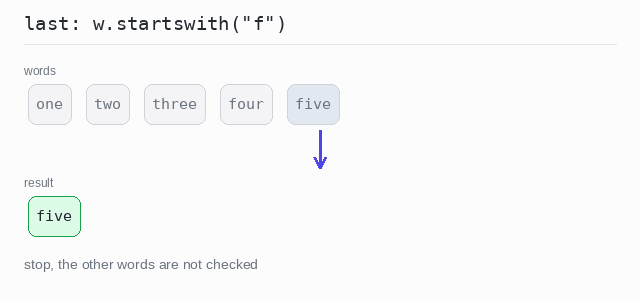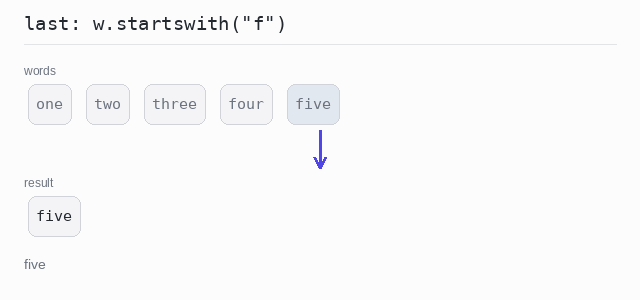
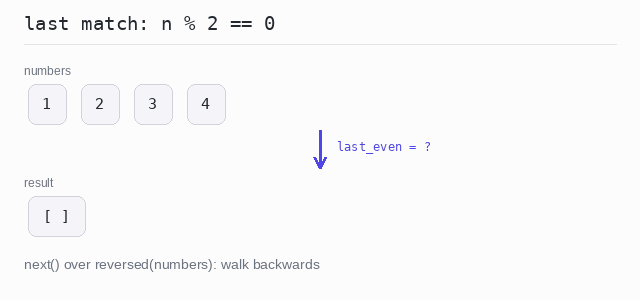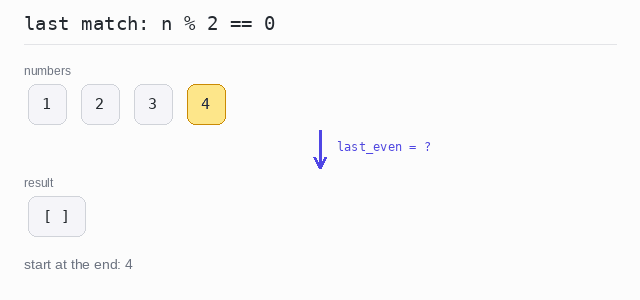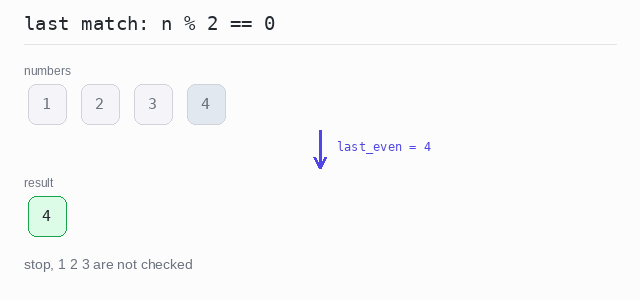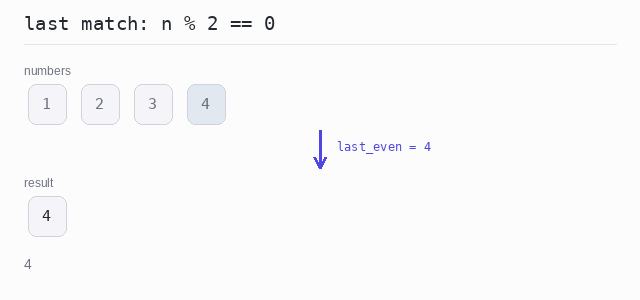
Функции для последнего совпадения нет. reversed() проходит список с конца, поэтому next() над генератором по перевёрнутому списку находит последнее совпадение: первое попадание при движении с конца — это последнее совпадение в списке.
Если значение по умолчанию — None, то «ничего не подошло» — это просто результат, для которого is None.
Первое совпадение
next() берёт первое слово, которое генератор выдаёт с условием len(w) > 3. Это слово three.
Вывод: полная программа на Python
words = ["one", "two", "three", "four", "five"]

# next() берёт первое значение, которое выдаёт генератор.
first = next(w for w in words if len(w) > 3)
print(first)
Последнее совпадение
Генератор проходит reversed(words), то есть начинает с конца. Первое встреченное слово, которое начинается с "f", — это five, поэтому next() возвращает его, а остальные слова не проверяются.
Вывод: полная программа на Python
words = ["one", "two", "three", "four", "five"]

# reversed() идёт с конца, поэтому первое совпадение — это последнее совпадение.
last = next(w for w in reversed(words) if w.startswith("f"))
print(last)
Первое совпадение или None
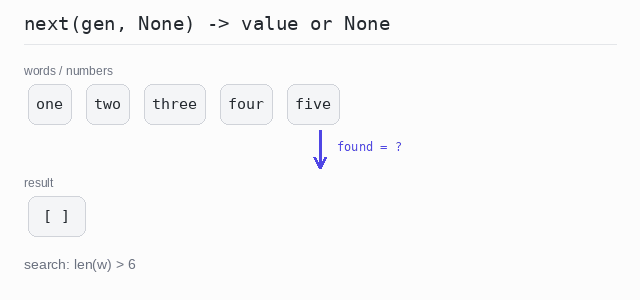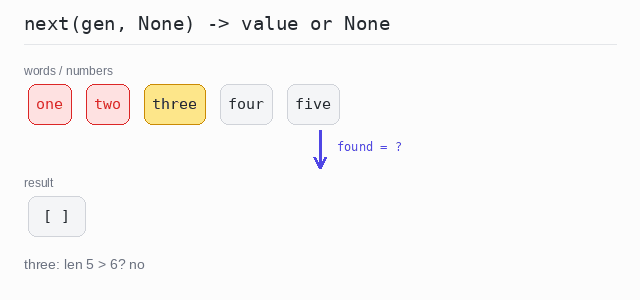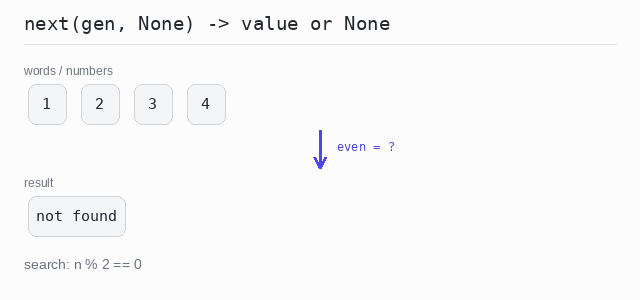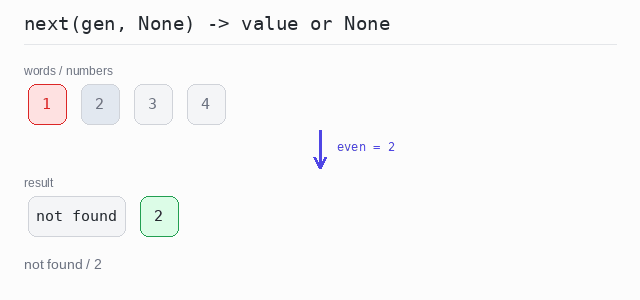
Ни одно слово не длиннее 6 букв, поэтому next() возвращает значение по умолчанию None, и программа выводит «не найдено». В списке чисел первое чётное число — 2.
Вывод: полная программа на Python
words = ["one", "two", "three", "four", "five"]
numbers = [1, 2, 3, 4]

# Второй аргумент next() — значение по умолчанию на случай «ничего не подошло».
found = next((w for w in words if len(w) > 6), None)
if found is not None:
  print(found)
else:
  print("не найдено")

even = next((n for n in numbers if n % 2 == 0), None)
if even is not None:
  print(even)
Последнее совпадение или None
reversed(numbers) проходит числа с конца. Последнее чётное число — 4, и оно находится сразу.
Вывод: полная программа на Python
numbers = [1, 2, 3, 4]

# Идём с конца: первое чётное число с конца — это последнее чётное.
last_even = next((n for n in reversed(numbers) if n % 2 == 0), None)
if last_even is not None:
  print(last_even)
Получение с помощью селектора
Иногда нужно сначала изменить каждый элемент, а затем взять первый подходящий результат.
Функция-селектор выполняет изменение и возвращает None для неподходящих результатов. map() применяет селектор к каждому элементу, а next() с проверкой is not None берёт первый подходящий результат. Здесь список одновременно содержит число, строку и логическое значение (bool) — список Python может смешивать типы. str() превращает любое значение в текст.
Первое преобразованное значение, которое подходит
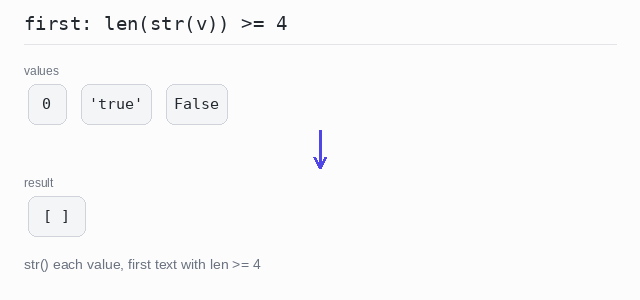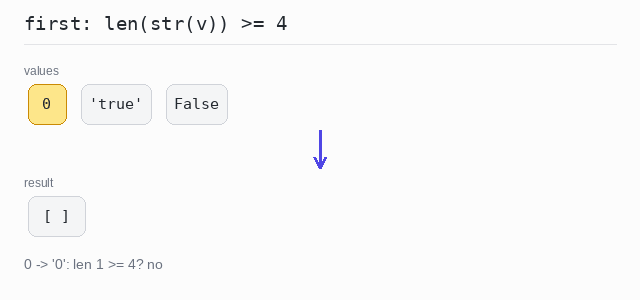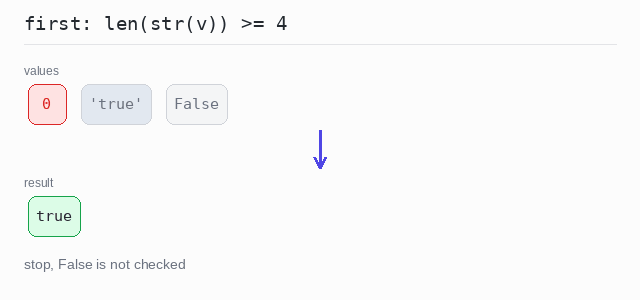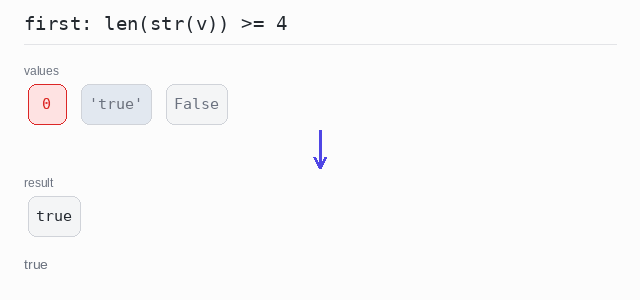
Каждое значение превращается в текст с помощью str(). 0 становится "0", а это слишком коротко, поэтому селектор возвращает None. В "true" 4 символа, поэтому это первый результат, не равный None, и программа выводит true.
Вывод: полная программа на Python
values = [0, "true", False]

def long_text(v):
  # Превращаем значение в текст; короткие тексты не подходят и становятся None.
  s = str(v)
  return s if len(s) >= 4 else None

# Первый результат селектора, не равный None.
found = next((s for s in map(long_text, values) if s is not None), None)
print(found)
Случайный элемент
Чтобы выбрать случайный элемент, выберите случайный индекс. Модуль random выдаёт случайные числа; rng.randrange(n) возвращает число от 0 до n-1, а это как раз диапазон допустимых индексов.
В Python также есть rng.choice(), который выбирает элемент напрямую. В этом примере сначала выбирается индекс, чтобы его было видно; choice() делает то же самое одним вызовом.
Генератор, созданный с помощью random.Random(42), начинает с фиксированного начального значения (seed). С тем же начальным значением программа каждый раз выбирает один и тот же элемент, поэтому вывод предсказуем — именно поэтому пример задаёт начальное значение своему генератору. Используйте random.Random() без начального значения, если хотите получать разный результат при каждом запуске.
Выбор случайного элемента
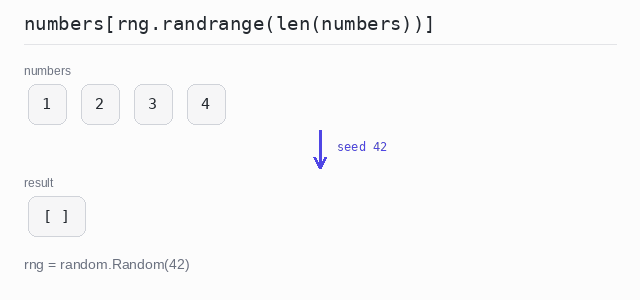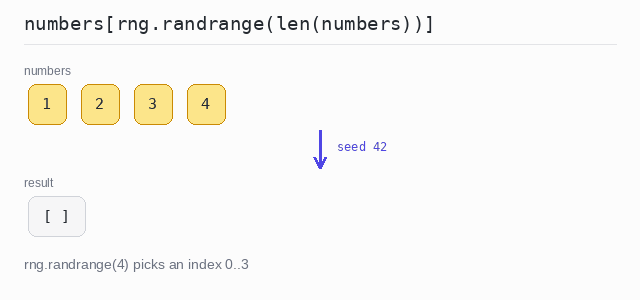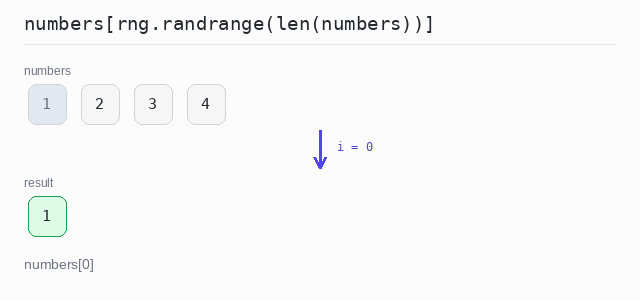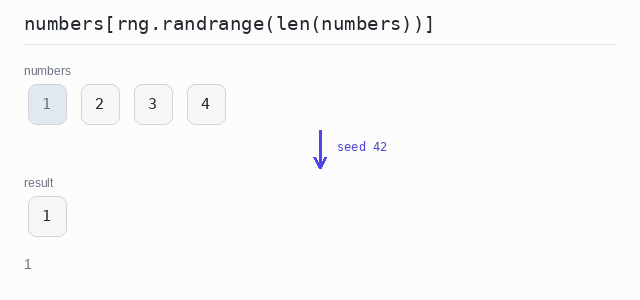
С начальным значением 42 генератор выбирает индекс 0, поэтому программа выводит 1. Измените начальное значение — и может получиться другое число.
Вывод: полная программа на Python
import sys

# Этот файл называется random.py, а Python сначала ищет модули рядом
# со скриптом. Убираем этот путь, чтобы "import random" нашёл настоящий модуль.
del sys.path[0]
import random

numbers = [1, 2, 3, 4]

# Фиксированное начальное значение (seed) делает «случайный» выбор одинаковым при каждом запуске.
rng = random.Random(42)
i = rng.randrange(len(numbers))
print(numbers[i])
Проверка наличия элемента
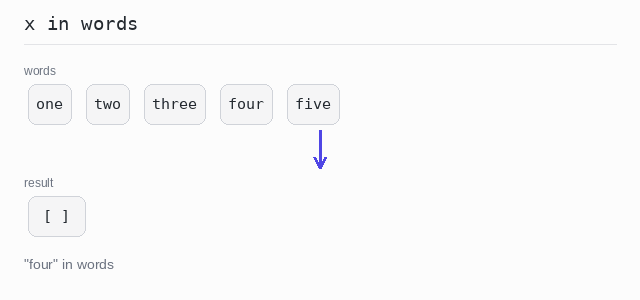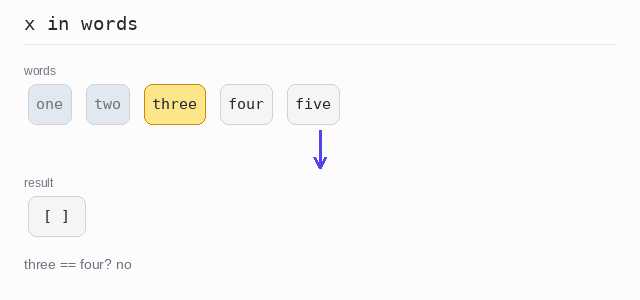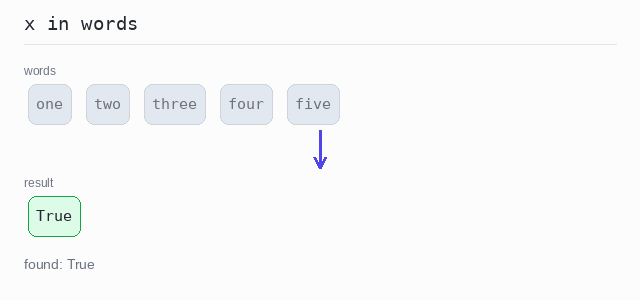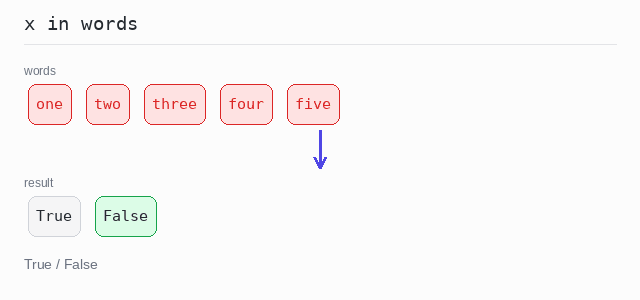
Чтобы проверить, есть ли значение в списке, используйте оператор in. Он возвращает True или False.
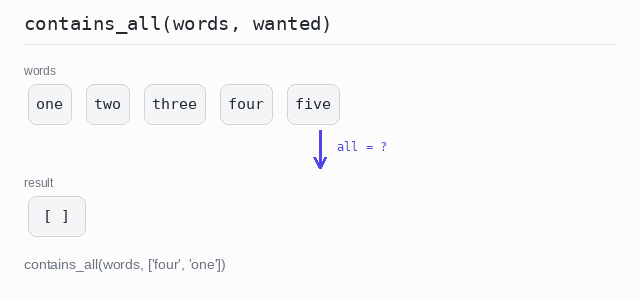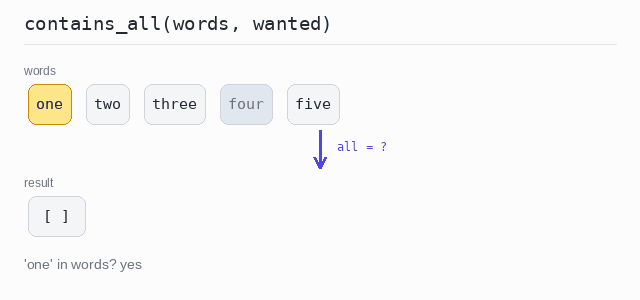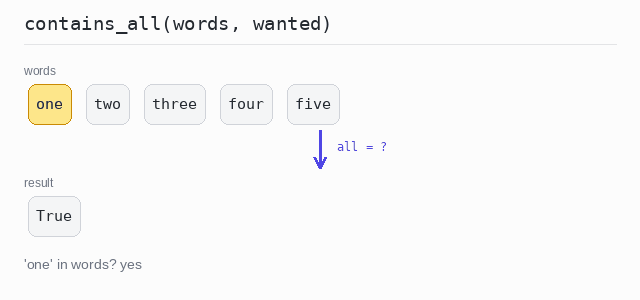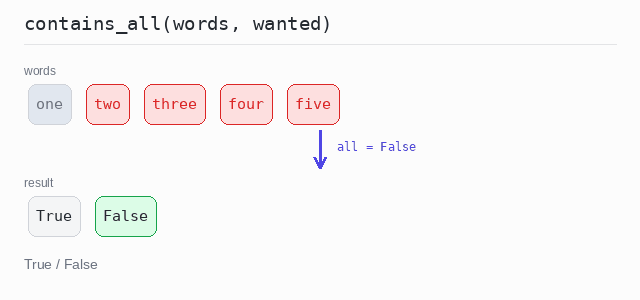
В Python нет contains_all(). Встроенная функция all() делает это в одну строку: all(v in items for v in wanted) равно True, только если найдено каждое нужное значение. Она останавливается, как только одного значения не хватает.
В Python также нет is_empty(). Сравните длину: len(s) == 0 означает «пусто», len(s) > 0 — «не пусто». В стиле Python это ещё короче: пустой список в условии считается False, поэтому в большинстве программ на Python пишут if not words: для «пусто» и if words: для «не пусто». На этой странице выводятся проверки длины, потому что они точно показывают, что именно измеряется.
Содержит одно значение
"four" есть в списке, поэтому первая проверка даёт True. "zero" в списке нет, поэтому вторая проверка даёт False.
Вывод: полная программа на Python
words = ["one", "two", "three", "four", "five"]

print("four" in words)
print("zero" in words)
Содержит все значения
И "four", и "one" есть в списке, поэтому contains_all возвращает True. "zero" отсутствует, поэтому второй вызов возвращает False.
Вывод: полная программа на Python
def contains_all(items, wanted):
  # True, только если каждое нужное значение найдено в items.
  return all(v in items for v in wanted)

words = ["one", "two", "three", "four", "five"]

print(contains_all(words, ["four", "one"]))
print(contains_all(words, ["one", "zero"]))
Пустой или не пустой
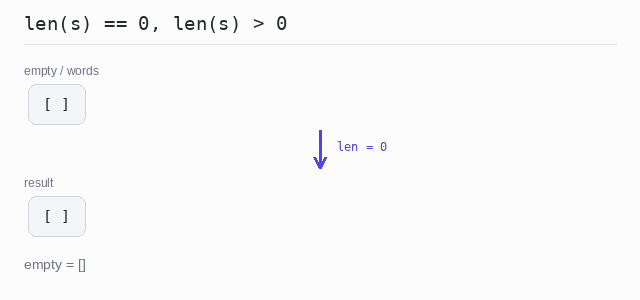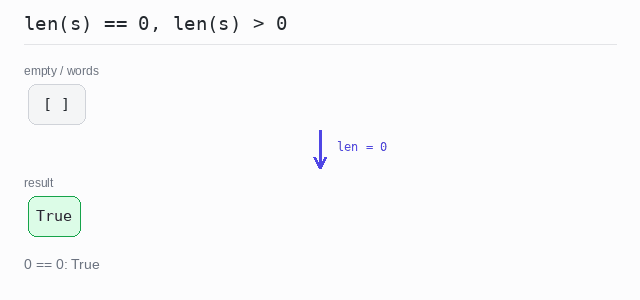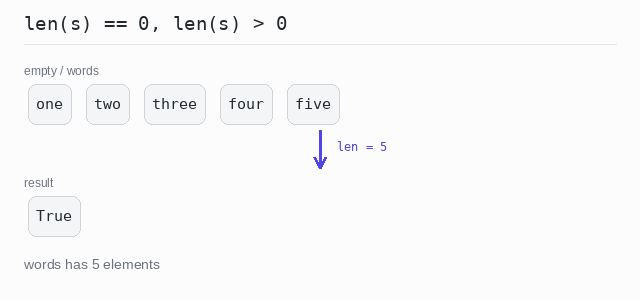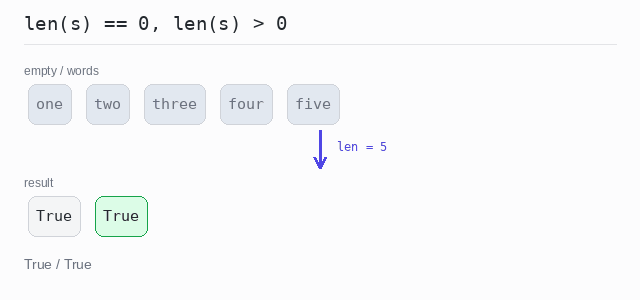
У empty длина 0, поэтому len(empty) == 0 равно True. В words 5 элементов, поэтому len(words) > 0 тоже равно True.
Вывод: полная программа на Python
words = ["one", "two", "three", "four", "five"]
empty = []

# Список пуст, если его длина равна 0.
print(len(empty) == 0)
print(len(words) > 0)